Claude Code 用哪个模型?按 Anthropic 官方定位分工:Sonnet 5.5 最擅长范围明确的日常任务和修 bug(Sonnet 5.5 发布页);Opus 5.5 为长时间运行的 Agent 编程和知识工作而设计(Opus 5.5 概览);Haiku 5.5 面向分类、抽取等高并发任务,官方称它适合在编程工作中给 Opus 5.5、Sonnet 5.5 当子 Agent(Haiku 5.5 发布页)。本文讲的是在 Claude Code 里怎么给三款模型分工、什么时候切换。两两对比见《Claude Sonnet 5.5 vs Opus 5.5》和《Claude Haiku vs Sonnet》。
从交付物选择模型
先把任务写成可验收的交付物,例如“修复这个分页错误,并保持旧接口行为”,比“看看项目有什么问题”更容易判断模型是否完成。
| 任务 | 起始候选 | 验收时看什么 |
|---|---|---|
| 找函数定义、提取日志字段、归类失败测试 | Haiku 5.5 | 路径、原文、字段是否准确完整 |
| 常规功能实现、已复现 bug、范围明确的代码审查 | Sonnet 5.5 | 测试、边界行为、无关改动 |
| 难复现故障、跨模块重构、复杂设计决策 | Opus 5.5 | 根因证据、方案约束、集成验证与返工 |
| 连续规划、调查并执行的长任务 | Sonnet 与 Opus 同任务评估 | 完成率、重试、人工接管和总耗时 |
Haiku 的官方定位偏向高并发、低延迟、分类和抽取;Sonnet 面向速度与能力平衡;Opus 面向长时间 Agent 编程与知识工作。这些定位支持安排评估顺序,不能替代仓库里的实际检查。Haiku 规格、Sonnet 规格、Opus 规格
API 单价怎么影响选择
以下单位为每百万 Token,普通速度、不含缓存创建、Batch、工具和其他附加费用。
| 模型 / 请求档位 | 未缓存输入 | 输出 | 缓存读取 |
|---|---|---|---|
| Haiku 5.5,prompt ≤100K | $0.10 | $0.50 | $0.01 |
| Haiku 5.5,prompt >100K | $0.50 | $2.50 | $0.05 |
| Sonnet 5.5 | $2.00 | $10.00 | $0.10 |
| Opus 5.5 | $4.00 | $20.00 | $0.20 |
Haiku 跨过 100K 后适用更高价格档。prompt 阈值的计数包含缓存相关输入,不能用“未缓存输入不足 100K”判断仍处于低档。Sonnet 和 Opus 的这两款型号使用标准长上下文费率。官方价格表
用一笔假设调用看返工影响:每次都是未缓存输入 50K、输出 5K,不含任何附加费用。Haiku 是 0.05×0.10 + 0.005×0.50 = $0.0075,Sonnet 是 $0.15,Opus 是 $0.30。
如果某个任务要调用 Sonnet 三次才能通过,相同用量假设下合计 $0.45;Opus 一次通过则是 $0.30。这个算例说明重试可能改变成本排序,不表示 Opus 已被证明一次成功,也不表示两款模型实际用量一样。选型时要使用每次请求的真实记录。
同样用量下官方价与 AICodeWith 价对比:
| 情景 | 模型 | 官方价 | AICodeWith 价 |
|---|---|---|---|
| 50K 输入 + 5K 输出,1 次 | Sonnet 5.5 | $0.15 | $0.0285 |
| 50K 输入 + 5K 输出,1 次 | Opus 5.5 | $0.30 | $0.057 |
| 50K 输入 + 5K 输出,Sonnet 调用 3 次 | Sonnet 5.5 | $0.45 | $0.0855 |
AICodeWith 价取自 定价页 2026 年 10 月 15 日 13:44 显示的折后价:Sonnet 5.5 输入 $0.38 / 输出 $1.90,Opus 5.5 输入 $0.76 / 输出 $3.80(每百万 Tokens,美元)。
Haiku 5.5 单价对比(每百万 Tokens;官方价为美元,AICodeWith 价为人民币,两者币种不同):
| 计费项 | 官方价(美元,prompt ≤100K) | AICodeWith 价(人民币) |
|---|---|---|
| 输入 | $0.10 | ¥0.1368 |
| 输出 | $0.50 | ¥0.684 |
Haiku 5.5 的 AICodeWith 人民币价格取自 模型页,2026 年 10 月 15 日 13:47 查看。
Claude Code 的 /usage 可以查看会话用量,但美元数字通常由客户端按价格计算。订阅用户的这一估计值不能直接当作额外账单;使用网关时,也要以渠道实际结算记录为准。Claude Code 成本说明
切换时固定型号,再决定是否使用别名
检查 claude --version。官方要求 Haiku 5.5 使用 v2.1.293 或更新版本,Sonnet 5.5 使用 v2.1.284 或更新版本,Opus 5.5 使用 v2.1.280 或更新版本。需要三款一起评估时,统一使用满足 Haiku 要求的版本。
新建会话可以分别运行:
claude --model claude-sonnet-5-5
claude --model claude-opus-5-5
claude --model claude-haiku-5-5
这三条命令是三个独立候选入口,按需要选一条执行。当前会话里可以用 /model claude-opus-5-5 等命令切换;它与启动新会话不一样,会保留已有对话,而且可能保存新的默认选择。
sonnet、opus、haiku 别名省去版本号,但不同提供商可能解析成不同版本。通过网关使用且希望固定别名时,可在现有配置的 env 中合并:
{
  "env": {
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "claude-sonnet-5-5",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "claude-opus-5-5",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "claude-haiku-5-5"
  }
}
这只是映射型号,不会新增账户权限,也不会让未提供的模型自动上线。使用支持多个模型的 API 中转服务时,可核对 AICodeWith Claude 渠道当前提供的型号和渠道信息,再以对应配置及真实调用记录验证。官方别名与版本规则
主模型和子 Agent 分开安排
Sonnet 处理主任务,Haiku 提取日志,Opus 调查难以解释的失败,是一种应用层分工。它不会因为你在提示里写了一句话就变成保证生效的自动路由。
自定义子 Agent 可以在定义中设置完整模型 ID;若使用 model: inherit,主会话切到 Opus 后,这类子 Agent 也可能随之运行在 Opus。只改 CLAUDE_CODE_SUBAGENT_MODEL 还不足以覆盖内置 Explore 和 Plan。配置后用 /tasks 查看实际型号,再对照提供商记录。子 Agent 模型选择
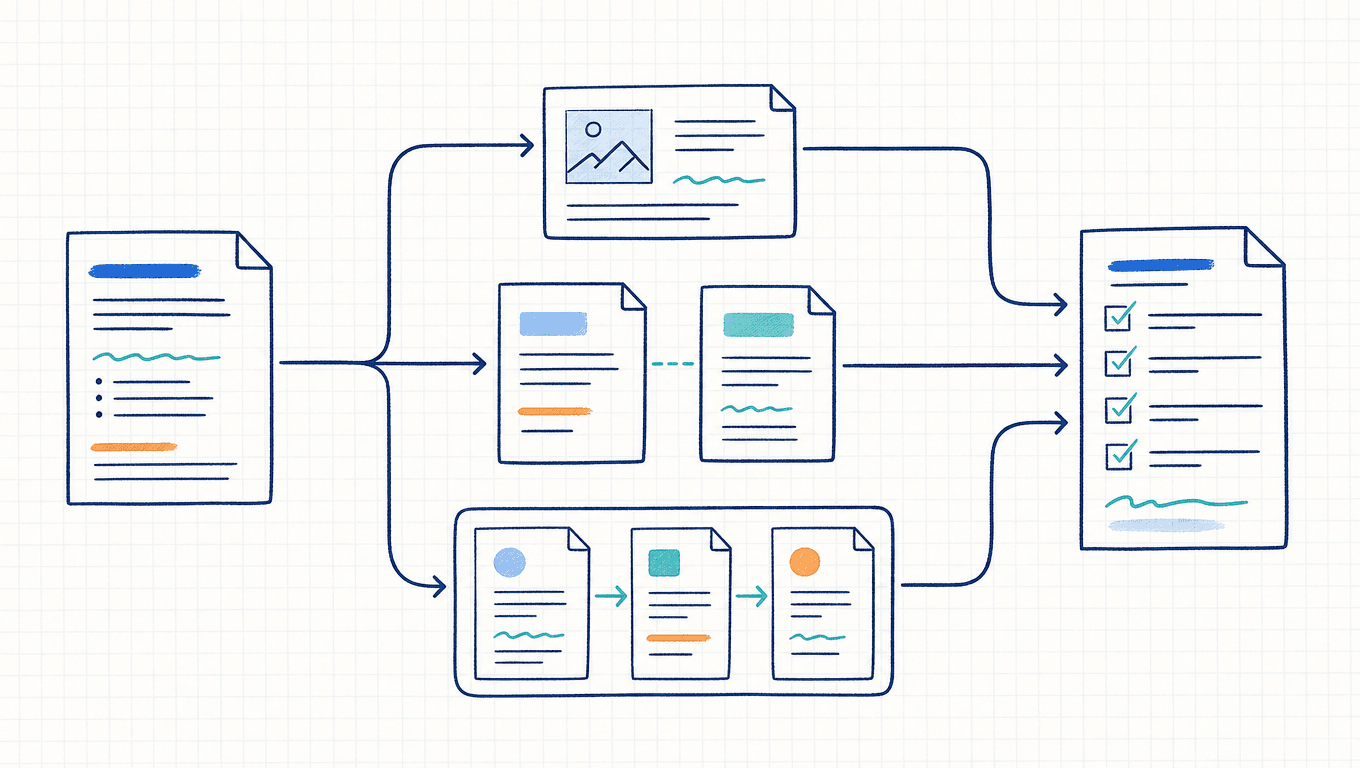
一个边界明确的分工例子是:Haiku 只返回失败测试名称、文件和日志证据;Sonnet 根据证据修复;若错误无法复现或改动跨越原定范围,停止自动修复,让主任务重新调查。需要 Opus 时,带上已确认事实、失败尝试和仍未解决的问题,不要把全部杂乱日志再塞进提示。
模型与 effort 分别评估
模型决定能力与单价档位,effort 调整其思考投入。高 effort 不能保证较小模型在所有任务上达到较大模型的效果,也不意味着大模型每次都要使用最高投入。
官方 API 默认 effort 为 Haiku medium、Sonnet high、Opus medium。比较默认体验时保留并记录这些默认差异;比较同投入设置时,显式使用两边都支持的级别,并另做记录。不要把不同实验混成一个“谁更快”的结论。
在支持该参数的当前版本,可通过启动参数评估:
claude --model claude-sonnet-5-5 --effort medium
对有固定验收规则的任务,先用中等投入,发现具体遗漏后再调整。Opus 5.5 的 thinking 始终开启;Sonnet、Haiku 在 API 层的思考设置也各有规则。已有应用切模型时,要检查原请求参数是否兼容,而不仅是修改 ID。
给模型升级设一个停止条件
先定义允许的尝试次数和失败类型。例如允许 Sonnet 完成一次实现和一次针对测试错误的修正;如果仍失败、需要改变架构或无法解释现象,就停止,汇总事实后评估 Opus。这个次数是团队的示例规则,不是 Claude Code 内置阈值。
换模型之前判断失败来源。如果是 Key 无效、地址不对、工具没有权限或测试环境损坏,升级模型不会修好接口。先修复执行环境,再比较模型能力。
评估时固定仓库版本、任务、工具权限、验收命令和重试上限,分别开新会话。记录通过率、总请求费用、耗时、人工修正和无关 Diff。总费用要包含失败请求、主会话处理子 Agent 结果的开销和缓存创建。
结论
从本周重复出现的一类任务开始。把验收稳定、费用可接受的模型作为该类任务默认,再用记录决定哪些失败值得升级。
常见问题
Claude Code 日常任务从哪款模型开始?
效率优先、范围明确的任务可以先评估 Sonnet 5.5;日志提取和文件查询等窄步骤可以测试 Haiku,复杂根因和跨模块调查再评估 Opus。以同一验收条件下的结果决定默认模型。
提高 effort 就能替代更强的模型吗?
不能据此保证能力相同。分别记录模型、effort、重试和人工修正,再比较合格任务的总费用与耗时。
相关资料
主模型仍在 Sonnet 与 Opus 之间犹豫时,继续看 Sonnet 5.5 与 Opus 5.5 的任务选择。准备把重复的小步骤移交 Haiku 时,分别核对它的 编程用途和 API 费用。